近日,我院与电子科技大学联合培养的首位博士后 Matee Ullah 以第一作者身份,在生物信息学领域国际知名期刊 Briefings in Bioinformatics 上发表题为"DeepIR-Pred: identification of insulin receptors using metaheuristic optimization of biologically informed multi-view features with deep recurrent learning"的研究论文。深圳信息职业技术大学为论文第一署名单位,博士后导师谭旭教授为共同通讯作者。值得一提的是,Matee Ullah 博士于今年成功获得国家自然科学基金海外学者基金资助,成为我校该类基金项目的首位获得者。此次高水平论文发表与科研项目获批,充分展现了学院在高层次青年科研人才培养以及人工智能与生命科学交叉研究领域取得的新进展。
一 期刊简介
Briefings in Bioinformatics(简称 BIB)由牛津大学出版社(Oxford University Press)出版,是生物信息学与计算生物学领域权威学术期刊(影响因子7.3,JCR Q1),关注生物数据分析方法及其应用,涵盖机器学习、深度学习、蛋白质结构与功能预测等方向,是人工智能与生命科学交叉研究的重要学术交流平台。
二 研究背景
胰岛素受体(Insulin Receptor,IR)是调控葡萄糖代谢、能量平衡和细胞生长的重要蛋白质,在胰岛素信号传导中发挥关键作用。胰岛素受体及其相关信号通路的异常与代谢性疾病、神经退行性疾病及肿瘤等有关。因此,准确识别胰岛素受体蛋白,有助于理解相关生物学机制,并为后续功能研究提供线索。
传统实验鉴定通常需要较多时间、经费和实验资源。随着蛋白质序列数据的快速积累,利用人工智能从氨基酸序列中学习功能信息,成为计算生物学的重要研究方向。
然而,蛋白质序列同时包含进化信息、理化性质和复杂的上下文关系,单一特征提取方法难以充分描述这些信息。如何融合不同视角的生物学特征,并从中筛选有效信息,是提高识别能力的关键问题。
三 研究内容
针对上述挑战,研究团队提出 DeepIR-Pred 框架,按照“多视角特征提取—智能特征优化—深度神经网络预测”的流程,实现胰岛素受体蛋白与非胰岛素受体蛋白的分类,如图1所示。
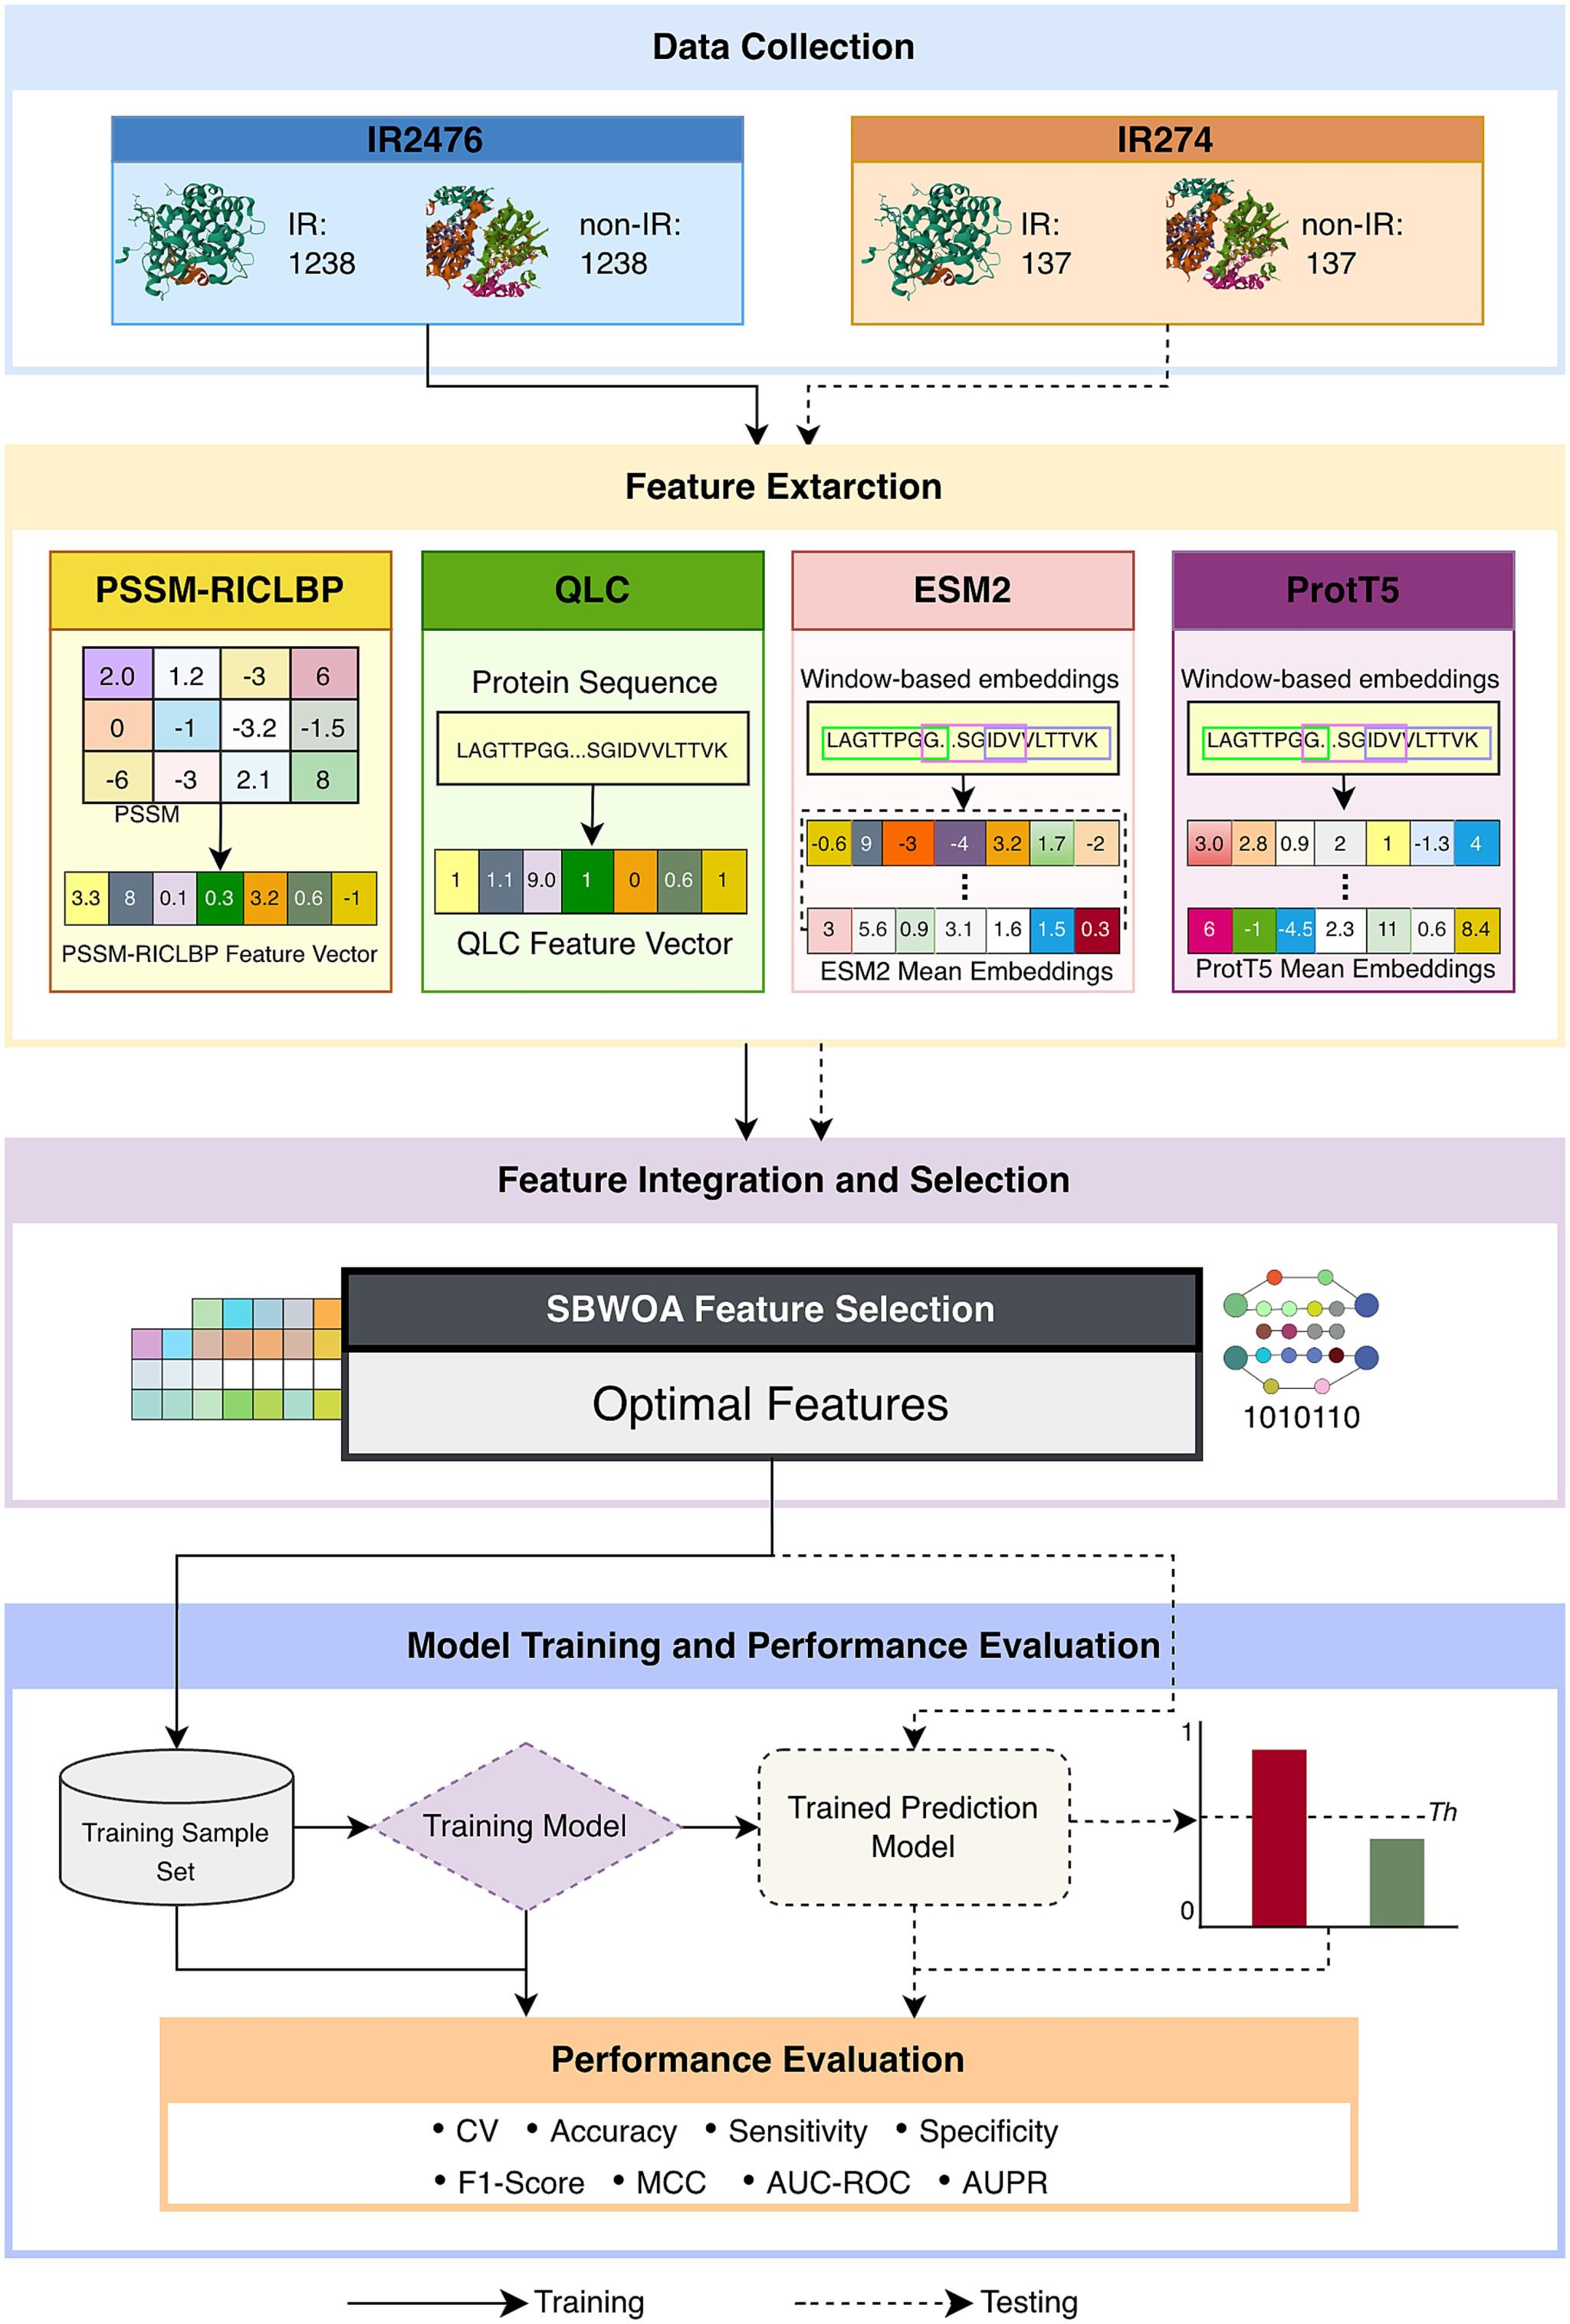
图1 DeepIR-pred 模型框架
1 多视角特征融合
研究综合利用四种互补的特征表示方法,从进化信息、理化性质和预训练序列表征等角度描述蛋白质。首先,团队提出 PSSM-RICLBP 特征提取方法,将蛋白质位置特异性评分矩阵(PSSM)转换为二维图像,再利用旋转不变的相邻局部二值模式共生特征提取其中的纹理信息。可以将其理解为:把反映序列进化规律的数字矩阵转成图像,再借助图像分析方法挖掘有用模式。其次,研究引入定性理化特征(QLC),描述氨基酸的电荷、极性、疏水性等性质,为模型提供具有生物学含义的信息。此外,研究使用 ESM2 和 ProtT5 两种蛋白质语言模型提取序列表示。类似于语言模型通过大量文本学习词语之间的关系,蛋白质语言模型通过大量氨基酸序列学习序列规律,为功能识别提供上下文信息。四类特征融合后,形成2723维蛋白质表示。
2 智能优化筛选关键信息
多种特征融合能够丰富蛋白质表示,也会带来维度较高、信息冗余等问题。为此,团队引入空间边界鲸鱼优化算法(Spatial Bound Whale Optimization Algorithm,SBWOA),在高维特征空间中搜索具有较强判别能力的特征组合。该算法借鉴鲸鱼觅食行为进行优化搜索。在实验中,融合特征由2723维精简至548维,减少约80%的特征维度,同时改善了分类表现。这展示了智能优化算法在生物信息学特征选择中的应用价值。
3 深度循环网络完成预测
在完成特征融合与筛选后,研究采用双向门控循环单元网络(Bidirectional Gated Recurrent Unit,BiGRU)作为预测模型,对输入特征表示进行双向处理,并通过分类层输出预测结果。团队比较了深度神经网络(DNN)、卷积神经网络(CNN)、双向长短期记忆网络(BiLSTM)、GRU 和 BiGRU 等模型。在该研究的实验设置下,采用优化后融合特征的 BiGRU 获得了最佳的整体表现。
4 模型验证与可解释性分析
研究构建了包含2476条蛋白质序列的训练数据集 IR2476,以及包含274条蛋白质序列的独立测试数据集 IR274,并通过十折交叉验证和独立测试评估模型性能。
评估方式 |
准确率 |
F1-Score |
AUC |
十折交叉验证(IR2476) |
95.96% |
95.93% |
0.9924 |
独立测试(IR274) |
93.82% |
93.82% |
0.9853 |
上述结果表明,DeepIR-Pred 在本研究数据集上具有较好的区分能力。AUC 衡量模型在不同判定阈值下区分正负样本的能力,数值越接近1,通常表示区分效果越好。除了比较预测指标,研究还结合 SHAP、LIME 等方法分析特征对预测结果的贡献,并通过 UMAP 可视化观察不同类别样本的分布。相关分析帮助研究者理解模型利用了哪些信息,并观察特征表示的类别区分情况。
四 研究意义与展望
该研究将蛋白质语言模型、图像特征提取、群智能优化算法与深度学习相结合,为胰岛素受体蛋白识别提供了一种计算方法,也为人工智能学院学生理解跨学科研究提供了具体案例。
对同学们而言,这项研究展示了一条将专业知识应用于真实科学问题的路径:理解任务与数据,设计互补特征,筛选关键信息,选择预测模型,再通过独立测试与可解释性分析评估结果。论文公开的数据与代码也可作为学习和复现实验的参考。
论文信息
论文标题:DeepIR-Pred: identification of insulin receptors using metaheuristic optimization of biologically informed multi-view features with deep recurrent learning
发表期刊:Briefings in Bioinformatics
发表时间:2026年9月28日
第一作者:Matee Ullah
通讯作者:谭旭
第一署名单位:深圳信息职业技术大学人工智能学院
论文链接:https://doi.org/10.1093/bib/bbag523
开源代码:https://github.com/MateeullahKhan/DeepIR-Pred

